

Claude Haiku 5.5は、推論が複雑になっても安易な近道をしません。重複行を見つけ、循環依存関係を反復計算し、適格性ルールを適用し、適切な尺度で統計を計算します。そして、その精度を実行のたびに維持します。これは、定期的に繰り返される業務にAIモデルを導入できるかどうかを左右する要素です。また、Haiku 4.5と比べて使用するトークン数を約27%削減し、約半分の時間で成果物を作成しました。
Claude Haiku 5.5を評価するため、BoxはBox Complex Work Evalを使用しました。これは、分析を伴うナレッジワークの主要な形態を対象に、実際の業務を想定し、ドキュメントに基づいて設計された一連のタスクです。各タスクは、適切なドキュメントを見つけ、スプレッドシート、PDF、プレゼンテーションを横断して推論し、ナレッジワーカーが実際に引き渡せる成果物を作成する必要があるAIエージェントを通じて、エンドツーエンドで実行されます。AIモデルのアウトプットは、約20〜30項目の重み付けされた詳細な評価基準に照らして採点されます。企業の業務で本当に重要なのは複数回の実行における一貫性であるため、各タスクは複数回繰り返されます。
このベンチマークで、Claude Haiku 5.5は60%を記録し、Haiku 4.5の49%を11ポイント上回りました。さらに、使用するトークン数を約27%削減し、実際の経過時間も約半分に短縮しています。
改善が表れた領域

Claude Haiku 5.5の優位性は、業務で必要となる数値計算の量が増えるほど大きくなります。最も大きな改善は、ソースデータからレポートを作成するタスクのおける19ポイントです。このタスクでは、AIモデルが適切な計算基準を選び、計算を行い、ドキュメント全体でその整合性を維持する必要があります。データ分析が10ポイントの改善でこれに続きます。これらは、誤った基準で集計したり、実際には導出していない数値を断定したりすると、AIモデルの評価が大きく下がるタスクです。
代表的なケースの1つが、50行のデータセットをAIモデルに渡し、複合スコアに基づいてランディングページを順位付けするキャンペーンパフォーマンスレポートです。Claude Haiku 5.5は、毎回完全に正しい分析結果を作成しました。Haiku 4.5は平均の取り方を誤り、ページごとの率の平均ではなく合計値をまとめて計算し、一部の実行ではまったく別の列を基準に順位付けしました。このようなタスクでは、どちらの答えも一見正しく見えます。そのため、一貫して正しい計算基準を選べるAIモデルは、もっともらしい答えを出すだけのAIモデルから大きく前進しています。
業界別
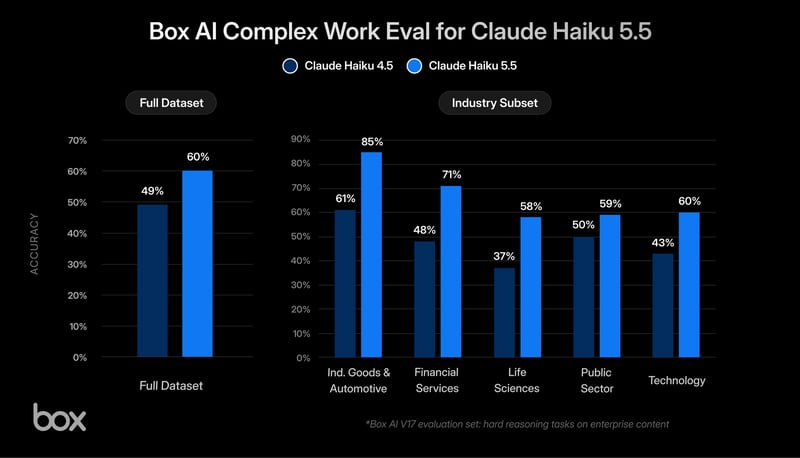
改善幅が最も大きいのは、数値計算の要求が特に高い分野です。こうした分野では、初期段階の1つの誤りが、その後のすべてのステップに波及します。
産業財・自動車(61%から85%): 設備のオーバーホール費用レポートでは、ソースのワークブックに明細行と並んで集計行が含まれていました。この列を単純に合計すると、総額が二重計上されます。Claude Haiku 5.5は重複を認識して除外しました。Haiku 4.5は重複を含めたうえ、正しく転記した数値についても別途加算を誤りました。
金融サービス(48%から71%): 当座借越を利用している企業の予測財務諸表を作成するよう求められると、AIモデルは循環依存関係に直面します。支払利息は当座借越残高に依存し、その残高は税金の支払いに依存し、税金の支払いは利息控除後の利益に依存します。Claude Haiku 5.5は収束するまで反復計算し、整合性の取れた財務諸表を作成しました。
ライフサイエンス(37%から58%): 診断製品の施設別パフォーマンスデータでは、Claude Haiku 5.5のばらつきの統計値はソースデータと整合していました。一方、Haiku 4.5は施設ごとの数値を正しく転記したものの、ばらつきの統計値を誤った尺度で計算し、1桁分ずれた結果となりました。そのため、後続するすべてのしきい値判定にも誤りが引き継がれました。
公共部門(50%から59%): ある図書館には7,500ドルの助成金があり、使用用途に関するルールが定められています。そのルールに適合する利用者からの要望のうち、最も人気の高いものを挙げるよう求めたところ、Claude Haiku 5.5は対象外の選択肢を除外し、その理由を説明したうえで、次に適格な項目を提示しました。Haiku 4.5は人気度で順位付けし、適格性の確認を省略したため、それぞれ助成金額の数倍に相当する選択肢を推奨しました。
テクノロジー(43%から60%): 投資アプリケーションのユーザーストーリーをレビューするタスクでは、各ストーリーを品質基準に照らして採点し、最も多く不合格となった基準を特定する必要がありました。Claude Haiku 5.5はストーリーごとの遵守率をより一貫して正しく算出し、「客観性」が最も多く不合格となった基準であることを正しく特定しました。Haiku 4.5は遵守率の計算を誤り、その結果、最も多く不合格となった基準も誤って特定しました。
企業の業務にとって何を意味するのか
ナレッジワークにAIモデルを導入する企業にとって、Claude Haiku 5.5は、複数ステップの定量分析、ドキュメントレビュー、構造化レポート作成など、実際に重要性の高いタスクでHaiku 4.5から明確に進化しており、より高速に回答を返します。スピードと正確性の両方が重要となる大量処理の業務では、より強力で効率的な選択肢です。
関連コンテンツ
- Claude Haiku 4.5とBox AIでAIのパフォーマンスと予算を最適化
- Claude Opus 5.5: 高品質な業務をより速く、効率的に
- First look: Claude Fable 5.1が複雑な企業業務における精度、レイテンシ、効率性を向上
- ローデータからインサイトへ: Box AIでClaude Opus 4.6による推論
このブログは Box, Inc 公式ブログ(https://blog.box.com/)2025年10月7日付投稿の翻訳です。
著者: Aditi Tuli, Product Manager, Box AI
原文リンク: https://blog.box.com/claude-haiku-55-boosts-accuracy-and-halves-latency
