

メタデータ抽出とは、非構造化ファイルの中に埋もれている重要なビジネス情報(当事者、日付、金額、分類、義務、ステータスなど)を自動的に特定し、アプリケーション、分析システム、AIエージェントが利用できる構造化データとして保存するプロセスです。
ドキュメント内のテキストを取得する全文抽出とは異なり、メタデータ抽出は、その情報が何を意味するのかを特定し、実際に活用できる状態にします。
多くの企業向けAIプログラムは、同じ地点で行き詰まります。AIモデルは機能します。データが機能しないのです。企業の業務を支える構造化データはデータウェアハウスやCRMに存在する一方、そのデータに意味を与えるコンテキストや根拠は、検索可能なように構造化されることのなかった契約書、ポリシー、保険金請求ファイル、トランスクリプトの中に埋もれたままです。
このギャップは数値でも明らかです。BoxがThe Harris Pollと共同で実施した「企業におけるAI利用の現状」調査では、96%の組織が、自社固有のコンテンツにAIエージェントがアクセスできることは重要だと回答しています。一方、すでにAIエージェントを利用または試験導入している組織のうち、信頼できる社内コンテンツにAIエージェントを接続し、それを少数のユースケースを超えて活用できているのは36%にとどまりました。ほぼすべての企業がそれを望んでいるにもかかわらず、実現できているのは約3分の1にすぎません。同じ調査では、49%が、後続のワークフローを動かすうえで構造化データの自動抽出は非常に重要だと回答しています。AI活用が最も進んでいる企業では70%、最も初期段階の企業では36%でした。
メタデータ抽出は、残り3分の2の企業がこのギャップを埋める方法です。テキスト抽出がドキュメントの内容を取得するのに対し、メタデータ抽出は重要な情報が何を意味するのかを特定し、ソースコンテンツに関連付けられた属性として構造化します。本ガイドでは、メタデータ抽出とは何か、OCRとの違い、プラットフォームに求めるべき要件、アウトプットをどのように管理するか、そして規制産業でどのように活用されるかを解説します。
企業コンテンツにおけるメタデータ抽出とは?
メタデータ抽出とは、ドキュメント、画像、PDF、契約書、請求書、フォームなどの非構造化コンテンツの中にある重要な情報を特定し、それを構造化された利用可能なデータに変換したうえで、ソースファイル上の構造化フィールドとして書き戻すプロセスです。このプロセスの利点の1つは、非構造化コンテンツをAIモデルやAIエージェントが理解し、利用しやすくすることです。
メタデータ抽出は、より広い分野であるAIを活用したデータ抽出の一形態です。フィールドが、単なる切り離されたコピーになるのではなく、ソースドキュメントの権限、バージョン、保持ポリシーを継承するとき、それは企業向けメタデータ抽出になります。
例を使って説明しましょう。契約書から、顧客ID、契約形態、発効日、更新日、地域、ステータスが得られるとします。
また、契約書には記載情報以外にも違いがあります。フォーマットはさまざまで、フィールドには法的な影響があり、アクセスルールは厳格で、アウトプットは別の場所に保管されているレコードと結合する必要があります。メタデータ抽出を活用することで、バージョン管理と記録管理を簡素化し、より多くのワークフローを自動化し、セキュリティインシデントのリスクを低減できます。
重要なのは、テキストを抽出することと、それが何を意味するのかを理解することの違いです。全文抽出であれば、ドキュメント内の「September 30, 2027」を見つけることができます。メタデータ抽出は、それが顧客の契約更新日であると理解し、そのように取得します。これにより、ドキュメントに埋もれていた情報が、企業が検索、分析、アクションに利用できる構造化データへと変わります。
抽出されたフィールドは、ソースファイルとの接続が維持されることで、さらに価値が高まります。この接続によって、元のコンテンツのコンテキスト、権限、バージョン履歴、データ分類が維持されると同時に、その情報がどこから得られたのかというプロベナンス(出典)も保持されます。その結果、アプリケーション、ワークフロー、AIは、背後にあるソースのコンテキストを失うことなく構造化データを利用できます。
ここに、「機能としての抽出」と「アーキテクチャとしての抽出」の違いがあります。ツールはフィールドを生成します。一方、ガバナンスされたコンテンツレイヤは、ソースドキュメントの権限、バージョン、ポリシーを引き継いだフィールドを生成します。そのため、AIアプリケーションごとにアクセスモデルを再構築することなく利用できます。
メタデータ抽出はOCRや従来のデータ抽出とどう違うのか?
光学式文字認識(OCR)は、画像を機械が読み取れる文字に変換します。ただし、その意味を解釈するわけではありません。従来のインテリジェントドキュメント処理はさらに一歩進み、正規表現、位置ベースのテンプレート、機械学習分類器、ルールエンジンなどの手法を使って、特定の情報を識別・抽出していました。
これらのアプローチは、予測可能なドキュメントタイプではうまく機能しますが、フォーマット、レイアウト、コンテンツが変化すると、多くの場合、相当な設定とメンテナンスが必要になります。特定の部門やドキュメントタイプ向けに設計されたポイントソリューションは、その複雑さを軽減できますが、その代わり幅広い用途への適用性が失われます。
AIを活用したメタデータ抽出は、ドキュメント内のコンテキストと意味を利用してフィールドを特定するため、バリエーションごとにテンプレートを用意することなく、サプライヤ、法域、フォーマットの違いに対応できます。より高度な抽出システムでは、抽出対象を決定し、結果を検証し、ユーザーや後続システムが信頼性を評価するための信頼度シグナルを提供するために、思考連鎖による推論、抽出向けに最適化された検索拡張生成(RAG)、抽出値の品質を評価するグレーダーなど、複数のAI技術を組み合わせることもできます。
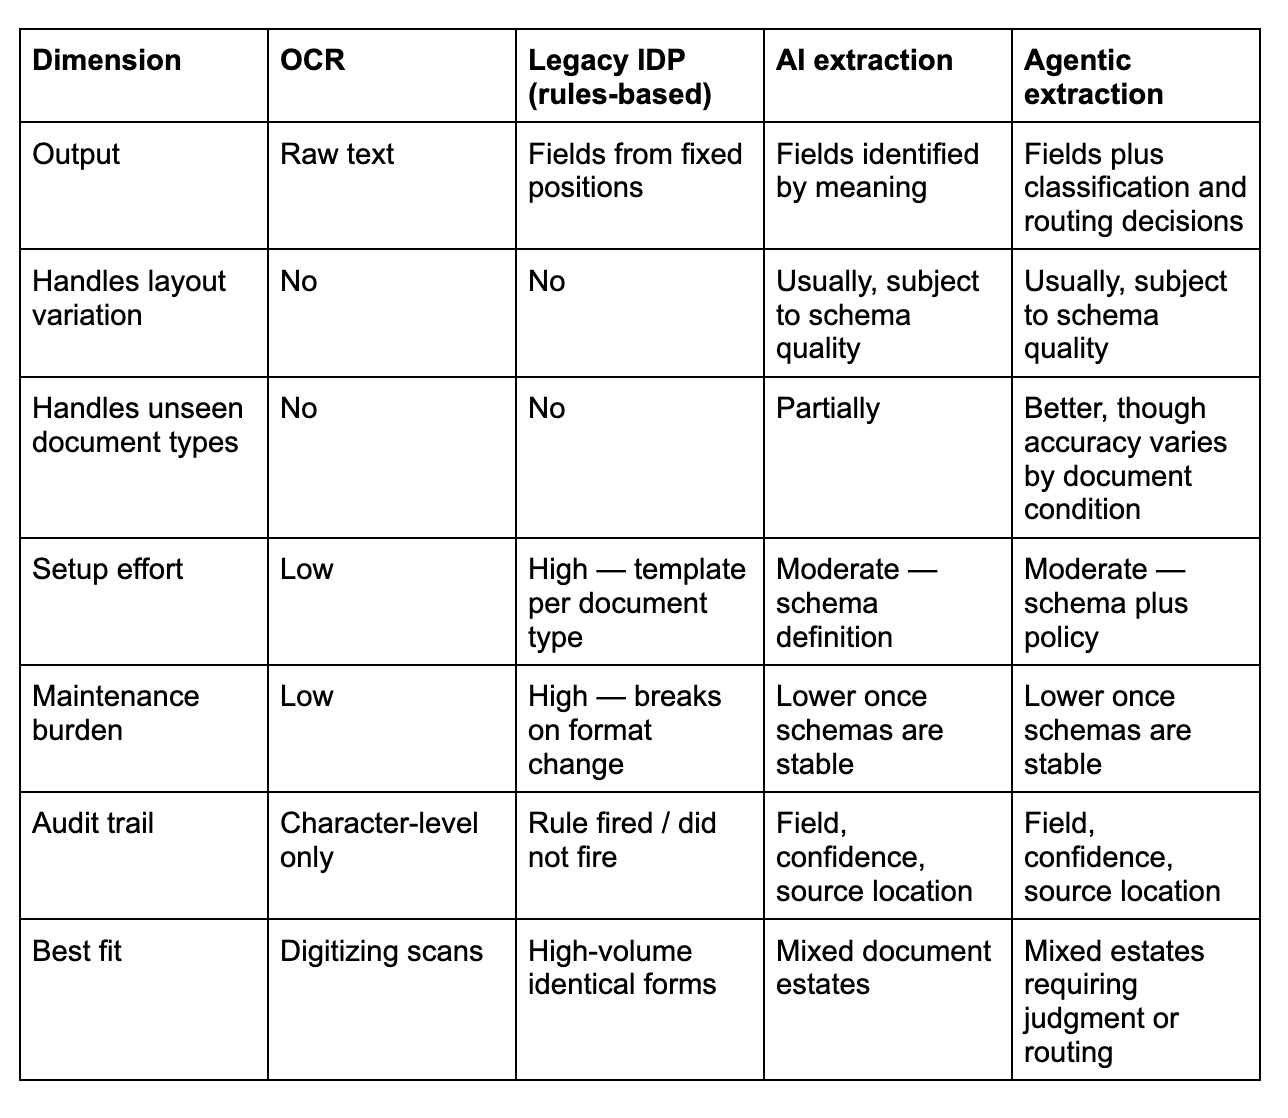
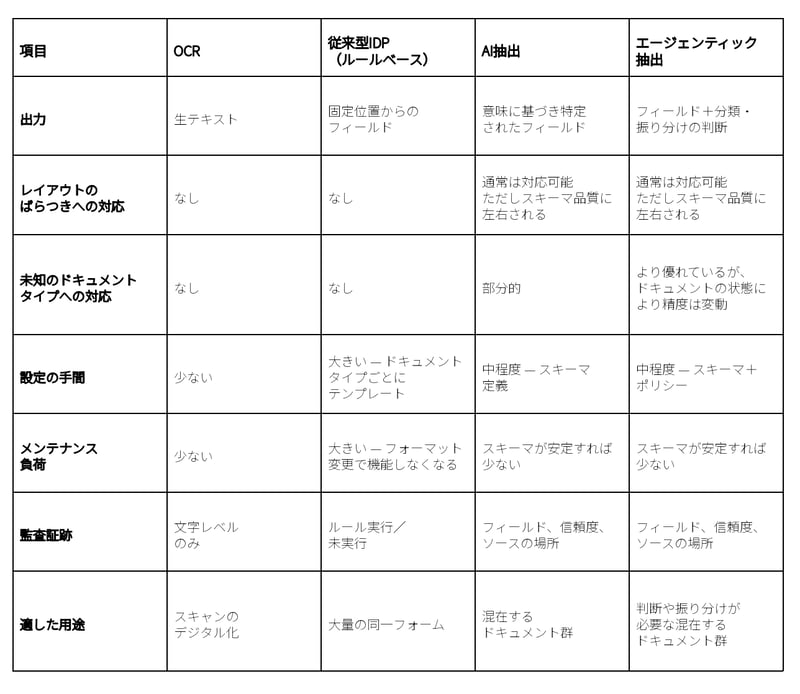 これらは市場カテゴリーであり、製品の階層ではありません。右側の列は、各アプローチによって何が可能になるかを示したものであり、どの実装でも保証される内容を示すものではありません。精度は、ドキュメントの状態、スキーマの品質、設定、検証設計によって異なります。
多くの企業は、複数種類のデータ抽出ツールを導入しています。契約書群を例にすると、スキャンされた過去の契約書にはOCRを使い、それ以降に署名されたすべての契約書にはAI抽出を使い、両方に同じメタデータテンプレートを適用する、といった使い分けです。
OCRと統合された、モダナイズされたインテリジェントなデータ抽出を組み合わせることで、インテリジェントドキュメント処理は、より強力で実用的なメタデータ抽出の選択肢になります。
非構造化ドキュメントから構造化データを大規模にどのように抽出するのか?
構造化抽出は、非構造化ドキュメントの情報を、予測可能でスキーマに準拠したデータへ変換します。望ましい構造を、たとえばメタデータテンプレートを通じてあらかじめ定義し、システムが対応する値を特定して返します。各抽出フィールドの信頼性を示す信頼度シグナルを付与できる場合もあります。
これは、自然言語のプロンプトによってAIモデルに情報の解釈や返却を依頼し、あらかじめ定義されたスキーマへの準拠を求めない自由形式の抽出とは異なります。基になるドキュメントがさまざまでも一貫した構造化アウトプットを生成することで、構造化抽出は、ドキュメントのデータをアプリケーション、分析、ワークフロー、AIで大規模に利用できるようにします。
非構造化データ抽出とは?
非構造化データ抽出は、ドキュメント、メール、スキャン、画像など、あらかじめ定義されたデータモデルに準拠しないコンテンツから有用な情報を特定します。メタデータ抽出は、単に生のテキストを返すのではなく、顧客名、契約金額、更新日、ドキュメントタイプなどの定義済みフィールドとして取得することで、その情報に構造とビジネス上の意味を付加します。同じアプローチはビジュアルコンテンツにも適用でき、AIはスキャンされたドキュメント、写真、その他の画像に含まれる情報を特定して構造化できます。
エージェンティックドキュメント抽出は従来のOCRとどう違うのか?
OCRはドキュメントに何が書かれているかを示します。エージェンティックドキュメント抽出は、その情報が何を意味するのかを判断し、アプリケーション、ワークフロー、分析、AIが利用できる構造化データへ変換します。また、抽出値を検証し、信頼度シグナルを提供することで、ドキュメント中心のプロセスをより高い信頼性で自動化できるようにします。
ドキュメントからのメタデータ抽出をどのように自動化するのか?
AIを使って、ドキュメント内のビジネスに関連する情報を特定し、あらかじめ定義されたスキーマに従って構造化し、そのデータをアプリケーション、ワークフロー、分析、AIで利用できるようにすることで、メタデータ抽出を自動化します。企業全体で、新しいコンテンツが到着した時点でメタデータ抽出を自動実行したり、オンデマンドで開始したり、APIを通じてプログラムからトリガーしたりできます。
一般的な自動ドキュメント抽出プロセスには、取り込み、分類、抽出、検証、アクションの5つの段階があります。
取り込み: コンテンツは、アップロード、メール、スキャナー、API、既存のコンテンツリポジトリなどのソースから抽出プロセスに入ります。
分類: 必要に応じて、システムは契約書、請求書、保険金請求、申請書など、どのタイプのドキュメントかを判断し、適切な抽出スキーマを適用できるようにします。ほかの場合には、ドキュメントの保存場所や抽出を開始したプロセスに基づいて、ドキュメントタイプやスキーマがすでに分かっていることもあります。
抽出: AIはスキーマで定義された情報を特定し、構造化フィールドとして取得します。契約書の場合、取引相手、発効日、更新日、契約金額、準拠法、支払条件などがフィールドに含まれる可能性があります。
検証: 抽出された値は精度を評価し、信頼度シグナルを割り当てることができます。それらのシグナルを使って、情報を自動的に次の工程へ進められる場合と、人による確認が必要なフィールドを判断できます。
アクション: 情報が構造化・検証されると、コンテンツの検索・整理、アプリケーションや基幹システム(SoR)への入力、分析への活用、後続の業務プロセスのトリガーに利用できます。
契約管理を考えてみましょう。新しい契約書が届くと、AIは契約の種類を特定し、顧客、契約金額、発効日、更新日などのフィールドを抽出できます。生成されたメタデータは契約書に関連付けたままにしつつ、ほかの企業システムでも利用できます。信頼度の低い値は確認へ回し、確認済みの更新日はアカウントチーム向けの更新ワークフローを自動的に開始できます。
構造化抽出にメタデータスキーマを使用する
構造化メタデータ抽出は、取得したい情報を定義することで機能します。メタデータスキーマまたはテンプレートによって、顧客名、請求金額、保険証券番号、更新日、ドキュメントタイプなどのフィールドを設定し、AIが非構造化コンテンツ内で対応する値を特定します。
AI専用に別のデータモデルを作成するのではなく、既存のメタデータスキーマを抽出先として利用できます。これにより、抽出された情報を、コンテンツの整理、ガバナンス、検索、自動化に使っている同じメタデータ構造の一部にできます。共通の識別子を使えば、ドキュメントのメタデータと、CRM、ERP、データウェアハウス、その他の企業システムに保存されている構造化情報を接続することもできます。
重要なのは、ソースドキュメント自体が同一の構造である必要はないという点です。AIを活用した抽出は、ドキュメントのレイアウト、フォーマット、サプライヤ、顧客、法域が異なっていても、一貫したスキーマ準拠のメタデータを生成できます。
企業全体でメタデータ抽出を自動化する
最新のAI抽出によって、かつてカスタムエンジニアリングプロジェクトだったものが、設定可能な機能へと変わりつつあります。どの情報を抽出するかを設定し、コンテンツがリポジトリやビジネスプロセスに入った時点で自動的に処理できます。
メタデータ抽出は、個々のドキュメントに対してオンデマンドで開始することも、移行、過去ファイルの処理、継続的な取り込みなどの大量処理ユースケース向けにAPI経由で呼び出すこともできます。ノーコード設定により、どの情報が重要かを理解しているユーザーでもメタデータ抽出を利用しやすくなり、APIを使えば、開発チームが同じ機能をより大きなアプリケーションや自動化プロセスに組み込めます。
業向けメタデータ抽出では、コンテンツのライフサイクルも考慮する必要があります。ドキュメントは時間とともに更新、置換、再分類、移動、削除されます。抽出されたメタデータや後続システムをソースコンテンツと同期させることで、アプリケーション、インデックス、分析システムが古い情報を基に動作するのを防げます。
抽出したメタデータをビジネス価値に変える
メタデータ抽出そのものが最終目的ではありません。その価値は、これまで非構造化コンテンツの中に閉じ込められていた情報を、企業が利用できる構造化データへ変えることにあります。
メタデータが存在すれば、ユーザーはコンテンツが保存されている場所やファイル名ではなく、コンテンツに何が含まれているかに基づいて検索、絞り込み、整理できます。アプリケーションや分析は、数千、数百万のドキュメントにまたがる情報を提示できます。ワークフローは、契約金額、更新日、保険金請求タイプ、承認ステータスなどの値に応じて動作できます。AIエージェントは、同じ構造化情報を利用し、追加のビジネスコンテキストを踏まえて企業コンテンツについて推論できます。
こうしたメタデータを企業コンテンツ全体に手作業で特定・適用する方法はスケールしません。Box Extractは、AIを活用したBox AI抽出エージェントを使って非構造化コンテンツ内の重要な情報を特定し、Box内のファイルに構造化メタデータとして直接適用します。メタデータはソースコンテンツとの接続が維持されるため、検索、アプリケーション、分析、AI、自動化ワークフロー全体で活用できます。
企業向けメタデータ抽出プラットフォームに必要な機能とは?
企業向けメタデータ抽出プラットフォームには、ドキュメントからフィールドを抽出する以上の機能が必要です。多様なコンテンツから信頼性の高い構造化データを生成し、抽出情報を検証・追跡する方法を提供し、企業システムやワークフローと統合し、基になるコンテンツのセキュリティとガバナンスを保護する必要があります。
企業向けメタデータ抽出プラットフォームを評価する際は、次の機能を検討しましょう。
- 抽出精度と評価: 自社のドキュメントと、ビジネスにとって重要なフィールドを使ってプラットフォームをテストします。評価では、単一の総合精度だけに依存せず、異なるドキュメントタイプ、レイアウト、フォーマット、エッジケースを考慮する必要があります。
- フィールド単位の信頼度と検証: 個々のフィールド単位で信頼度シグナルを確認できることが重要です。それに基づき、ビジネスリスクに応じて異なる検証ルールを適用できます。たとえば、契約金額や銀行口座番号は、リスクの低いフィールドより厳密な確認が必要になる場合があります。また、人による検証が必要な場合に、不確実な値を確認・修正するワークフローもサポートすべきです。
- 幅広いドキュメントとコンテンツのサポート: 企業コンテンツが単一のフォーマットに従うことはほとんどありません。ネイティブデジタルドキュメント、PDF、スキャン、写真、手書き、表、複雑なレイアウト、社内で使用する言語に対する性能を評価します。
- 柔軟なスキーマ管理: 再利用可能なスキーマまたはメタデータテンプレートを通じて、抽出したい構造化情報を定義できる必要があります。フィールド定義、データタイプ、抽出指示、ドキュメントタイプやビジネスプロセスをまたいだ再利用をサポートしているか確認します。
- プロベナンス(出典)とソースへのグラウンディング。抽出値は、その情報がどのコンテンツから得られたかを追跡できる必要があります。引用、ページ参照、バウンディングボックスなどの機能があれば、ユーザーは値が見つかった場所を検証でき、後続アプリケーションやAI生成回答の根拠を提供できます。
- 人によるレビューと例外処理: すべての抽出結果を同じように扱うべきではありません。企業プラットフォームには、不確実または高リスクな値をレビューに回し、ユーザーが修正し、検証済みの結果を後続プロセスへ組み込める仕組みが必要です。
- セキュリティ、ガバナンス、コンプライアンス: 情報を抽出することで、機密性の高い企業データのガバナンスされていないコピーを作ってはなりません。権限、アクセス制御、暗号化、監査可能性、データ保持、データレジデンシ、基盤となるAIモデルによる顧客データの利用をどのように扱うか評価します。
- 統合と自動化: 抽出したメタデータは、ほかのシステムが利用できることでさらに価値が高まります。構造化データをアプリケーション、分析プラットフォーム、基幹システム、自動化ワークフローへ流せるAPI、バッチ処理、イベント駆動型処理、統合機能を確認します。
- スケーラビリティと運用管理: 大量のドキュメント、同時実行される抽出ジョブ、失敗、再試行、監視、時間の経過に伴うスキーマ変更をプラットフォームがどのように扱うか評価します。企業向けメタデータ抽出は、新しいドキュメントタイプやビジネスプロセスごとにカスタムパイプラインを必要とせずにスケールできるべきです。
- AIの進化への適応性: AIモデルは今後も変化し続けます。企業向け抽出アーキテクチャは、スキーマ、統合、ガバナンスポリシー、後続プロセスを繰り返し再構築することなく、基盤AIモデルの改善による恩恵を得られるようにする必要があります。
コンテンツ管理システム内で直接動作するメタデータ抽出プラットフォームの場合、追加機能が大きな価値をもたらす可能性があります。抽出されたメタデータとソースコンテンツの接続を維持することで、コンテンツの既存のコンテキストとガバナンスを保持しながら、そのメタデータを検索、絞り込み、アプリケーション、ワークフロー、分析、AIですぐに利用できるようになります。
メタデータ抽出ソリューションを選ぶ際に確認すべき質問とは?
企業向けメタデータ抽出ソリューションを選ぶには、サンプルドキュメントからいくつかのフィールドを抽出できるかどうか以上の評価が必要です。購入側は、自社のコンテンツ全体でシステムがどれほど正確かつ信頼性高く機能するか、どれほど簡単に設定・管理できるか、抽出データをビジネス全体でどのように利用できるかをテストすべきです。
ベンダーには、次の質問をしてみましょう。
- 自社のドキュメントとフィールドで、抽出精度はどの程度か?
異なるドキュメントタイプ、レイアウト、フォーマット、エッジケースを含む代表的なコンテンツでテストするようベンダーに依頼し、抽出品質をどのように測定しているか説明を求めます。 - プラットフォームは不確実性をどのように伝え、例外をどのように扱うか?
フィールド単位で信頼度を確認できるか、そのシグナルをどう解釈すべきか、不確実または高リスクな値を人によるレビューへ回せるかを確認します。 - 新しいドキュメントタイプやユースケースをサポートするには、どの程度の設定が必要か?
ユーザーが自ら抽出スキーマや指示を定義できるのか、それとも新しいユースケースごとにベンダーサービス、AIモデルの学習、カスタムエンジニアリングが必要なのかを確認します。 - 自社のメタデータスキーマを定義、再利用、管理できるか?
スキーマをユースケース間で共有できるか、時間とともに変更できるか、すでに使用しているメタデータ構造と統合できるかを確認します。 - 実際に保有しているコンテンツ全体で、プラットフォームはどの程度機能するか?
関係するネイティブドキュメント、PDF、スキャン、画像、手書き、表、複雑なレイアウト、言語、同じドキュメントタイプ内のバリエーションをテストします。 - 各抽出値は、そのソースとどのように接続されるか?
ソースファイル、ドキュメントのバージョン、ページ、引用、バウンディングボックスなど、どのようなプロベナンス(出典)情報を利用できるか、ユーザーが抽出値を基になるコンテンツと照合して検証する方法を確認します。 - 抽出データにセキュリティ、権限、ガバナンスはどのように適用されるか?
情報抽出によって別のアクセスモデルが作られるのか、それとも既存のコンテンツ権限とガバナンスポリシーが生成されたメタデータを引き続き保護するのかを確認します。 - 基盤となるAIモデルは顧客コンテンツをどのように扱うか?
顧客データがAIモデルの学習に利用されるか、処理がどこで行われるか、データがどのくらい保持されるか、機密情報や規制対象情報にどのような制御が用意されているかを確認します。 - 抽出したメタデータは、ほかのテクノロジースタックとどのように統合されるか?
API、バッチ処理、イベント駆動型自動化、アプリケーション、分析プラットフォーム、AIエージェント、ワークフロー、基幹システムとの統合を評価します。 - ソースコンテンツが変更された場合はどうなるか?
ドキュメントが更新、置換、再分類、移動、削除された場合や、データ保持またはリーガルホールドの対象となった場合に、抽出メタデータと後続システムがどのように対応するかを確認します。 - AIモデルの進化にプラットフォームはどのように適応するか?
基盤AIモデルの改善を採用する際、企業側でスキーマ、統合、ガバナンスポリシー、後続ワークフローを再構築する必要があるか確認します。 - どのようなセキュリティ、コンプライアンス、監査機能を利用できるか?
関連する認証、監査ログ、データレジデンシ、暗号化、データ保持制御、業界や規制環境に固有のその他要件を確認します。 - 運用面・経済面でどのようにスケールするか?
処理上限、スループット、監視、障害対応、抽出対象がより多くのドキュメント、フィールド、ビジネスプロセスへ拡大した場合に料金や消費量がどのように変化するかを確認します。
AIで抽出したデータをどのように管理するのか?
AIで抽出したメタデータは、その元となるソースコンテンツと同じ厳格さでガバナンスする必要があります。抽出されたメタデータがインデックス、データプラットフォーム、アプリケーション、AIシステムへコピーされるにつれて、すべての表現形式にわたって、明確な権威性、アクセス制御、データのリネージ(来歴)、ライフサイクル管理を維持する必要があります。
抽出データのコピーが増えるたびに、追加のガバナンス作業が発生します。だからといって、コピーを避けるべきだという意味ではありません。ベクトルインデックス、データウェアハウス、レイクハウス、業務システムには、いずれも正当な用途があります。重要なのは、どのシステムまたはレコードを正とするかを定め、派生したすべての表現形式をそのソースまで追跡可能にし、同期を維持することです。
したがって、ガバナンスされた抽出アーキテクチャは、いくつかの問いに答えられる必要があります。「誰がソース情報へのアクセスを許可されているのか?」「抽出値はどこから来たのか? 」「ソースが変更されたらどうなるのか?」「 どのコピーにその情報が含まれているのか?」 そして「監査の際に、それらの制御をどのように証明できるのか?」
NIST AI Risk Management Framework(米国国立標準技術研究所(NIST)が策定した、AIシステムの信頼性を高め、特有のリスクを管理するためのガイドライン)などのフレームワークは、より広範なAIガバナンスの実務を確立するうえで役立ちます。NISTはAIリスク管理をGovern(統治)、Map(把握)、Measure(測定)、Manage(管理)の4つの機能に整理しています。また、英国情報コミッショナー事務局が公開しているようなデータ保護ガイダンスでは、適法性、透明性、正確性、セキュリティ、説明責任などの考慮事項を扱っています。これらのフレームワークは特定の抽出アーキテクチャを規定するものではありませんが、実証できるべき成果を定義するうえで役立ちます。
ガバナンスされたメタデータ抽出では、特に次の5つの制御が重要です。
- アクセス制御: 抽出された情報によって、ユーザー、アプリケーション、AIエージェントが基になるコンテンツを保護する権限を迂回できるようにしてはなりません。コンテンツやユーザーアクセスが変化しても、認可状態を最新に保つ必要があります。
- リネージ(来歴)とプロベナンス(出典): 抽出情報をソースまで追跡できる必要があります。これには関連するドキュメントとバージョン、必要に応じてドキュメント内の位置、およびその値を生成したプロセスが含まれます。
- 検証と人による監督: 抽出情報を自動的に利用できる場合と、ビジネスリスク、規制要件、不確実性によって人によるレビューが必要になる場合を判断できる必要があります。必要に応じて、レビュー判断と修正を記録する必要があります。
- 監査可能性: 抽出、アクセス、レビュー、後続処理での利用について、企業のセキュリティ、コンプライアンス、規制要件に適した監査記録を生成する必要があります。
- ライフサイクル管理: ソースコンテンツが更新、置換、再分類、削除、保持、またはリーガルホールドの対象となった場合、派生メタデータや後続の表現形式をそれらの変更と整合させる仕組みが必要です。
更新日がドキュメントのメタデータと分析システムの両方に抽出されている契約書を考えてみましょう。契約変更によって更新日が変わった場合、後続の表現形式も、更新された正の情報を反映する必要があります。契約書へのアクセス権が変わった場合、複製されたデータが制限情報への意図しないアクセス経路にならないようにする必要があります。また、契約書がリーガルホールドの対象になった場合、関連情報はデータ保持および法的要件に従って管理されなければなりません。
データ抽出ワークフローで、データプライバシーをどのように管理するのか?
抽出ワークフローにおけるデータプライバシーは、ソースコンテンツと抽出情報がどのように処理、保存、アクセス、保持、共有されるかを制御することにかかっています。コンテンツが抽出のためにどこへ送信されるのか、サービスがどのデータを保持するのか、顧客コンテンツがAIモデルの学習に利用されるのか、どのレジデンシ要件が適用されるのか、抽出後に派生メタデータがどのように保護されるのかを理解する必要があります。
ガバナンスされたコンテンツ環境内で直接情報を抽出することで、管理しなければならない追加のコピーやアクセスモデルの数を減らせます。情報をほかのシステムへ複製する場合は、正となるソースへのリネージ(来歴)を維持し、それぞれの派生形態に適切な制御を適用することで、データライフサイクル全体の説明責任を維持できます。
メタデータ抽出は業界ごとにどのように活用されているのか?
メタデータ抽出は、重要なビジネス情報がドキュメントやその他の非構造化コンテンツの中に閉じ込められているあらゆる業界で利用されています。具体的なフィールドはユースケースによって異なりますが、パターンは共通しています。関連情報を特定し、定義済みスキーマに従って構造化し、検索、分析、アプリケーション、自動化ワークフローで利用できるようにします。
法務: 法務部門は、メタデータ抽出を使って契約書を構造化された検索可能なデータへ変換できます。AIは、契約ポートフォリオ全体から、当事者、準拠法、発効日・満了日、更新条件、補償条項、譲渡制限、その他の重要な義務を取得できます。これにより、すべてのドキュメントを個別に確認することなく、「次の四半期に自動更新される契約書はどれか」「特定の義務を含む契約書はどれか」といった質問に答えられます。法律事務所は同じアプローチを使って、MSA、NDA、その他の契約書全体にわたる条項や先例の検索可能なライブラリを構築できます。数百ページに及ぶドキュメントを扱うBarnett Capitalは、抽出メタデータを使って、どの賃貸契約が最も早く満了するかで整理したビューを構築し、各ドキュメントに35〜40の質問を行っていると報告しています。
金融機関: 金融機関は、ドキュメント抽出とメタデータ抽出を使って、請求書、ローン契約書、投資記録、明細書、その他の金融コンテンツから構造化情報を取得できます。抽出フィールドには、ベンダー名、請求金額、発注番号、借り手情報、ローン条件、金利、満期日、コベナンツの詳細などが含まれます。構造化された情報は、融資審査を迅速化し、照合を支援し、後続システムへ入力し、確認が必要な例外を特定できます。Barnett Capitalは、メタデータ抽出によって融資審査を60倍高速化したと報告しています。Makena Capital Managementは、以前のシステムから引き継いだ80万件のレガシー金融ドキュメントをフラットな構造で保有していましたが、それらに対してメタデータを抽出することで、アナリストが対象情報を探す時間を約1時間から約1分に短縮しました。
保険: 保険会社は、保険金請求フォーム、写真、査定担当者のメモ、連絡文書、保険証明書、特約、価額明細、損害履歴などでメタデータ抽出を利用できます。抽出情報には、保険証券番号、請求者、損害発生日、車台番号(VIN)、負傷の詳細、金額、その他の保険金請求属性などが含まれます。構造化データは、保険金請求システムへの入力、トリアージの支援、不足・不整合情報の特定、案件を自動処理できるか査定担当者の確認が必要かの判断に利用できます。ForresterのCraig LeClair氏は、保険金請求は請求書処理よりも大きな機会であると主張しています。事故の第一報や複雑な自動車事故ワークフローでは、単なるフィールド取得ではなく、案件を組み立てるための抽出が必要になるからです。US Acute Care Solutionsはこれを医療請求に適用し、請求書類から自動車事故の証拠があるかどうかを抽出によって確認しています。
人事: 人事部門は、履歴書、オファーレター、オンボーディング資料、人事ファイルから候補者・従業員情報を抽出できます。連絡先情報、面接日、報酬、入社日、役割、従業員識別子などのフィールドを、応募者追跡システムやHCMシステムへの入力、オンボーディングの自動化、従業員記録の整理に利用できます。人事コンテンツには機密性の高い個人情報が含まれることが多いため、抽出ワークフローでは適切なアクセス制御、保持ポリシー、プライバシー保護を維持する必要があります。
政府・公共部門: 公共機関は、許認可、公開記録の処理、助成金管理、給付案件、調達、その他のドキュメント中心のサービスでメタデータ抽出を利用できます。AIは、申請情報、案件識別子、日付、住所、資金額、適格性情報、法定期限などを抽出し、記録をより一貫してルーティング、追跡、検索、処理できるようにします。
AIを使った自動メタデータ抽出ワークフローの構築方法
自動メタデータ抽出ワークフローは、非構造化コンテンツを、構造化されたビジネスデータを必要とするシステムやプロセスへ接続します。一般的な実装では、抽出する情報を定義し、抽出を実行するタイミングを決め、アウトプットを検証し、生成されたメタデータをアプリケーション、ワークフロー、分析、AIで利用できるようにします。
抽出のトリガー方法を選ぶ
メタデータ抽出は、ユースケースに応じてさまざまな方法で実行できます。ドキュメントのアップロードや変更時に自動的に開始する、個々のファイルに対してオンデマンドで実行する、API経由で大規模なバッチを処理する、より広範なタスクの一部としてAIエージェントから呼び出す、といった方法があります。
APIとSDKは、アプリケーション側ですでに実行内容が分かっている決定論的な処理に適しています。たとえば、ドキュメントから定義済みのフィールドセットを抽出する、ファイルのバッチを処理する、構造化アウトプットを別のシステムへ書き込む、といった処理です。
AIエージェント用ツールやMCPなどのプロトコルは、コンテキストに基づいてAIエージェントが次のアクションを決定する、より動的なワークフローをサポートできます。AIエージェントは、ポリシーを検索したり、契約書を取得したり、ドキュメントのバージョンを比較したり、特定の情報を抽出したり、別のビジネスアクションを開始したりできます。これらのツールは、基になるコンテンツを管理するものと同じセキュリティおよび認可の境界内で動作する必要があります。
抽出スキーマを定義する
繰り返し可能なビジネスプロセスでは、構造化抽出は、システムが返す情報を指定する定義済みスキーマから始まります。たとえば契約書スキーマには、取引相手、発効日、更新日、契約金額、準拠法などを含めることができます。
ソースドキュメント自体が同じレイアウトである必要はありません。AIを活用したメタデータ抽出は、異なるフォーマット、サプライヤ、法域、ドキュメントのバリエーションに含まれる情報を、一貫した構造化フィールドのセットにマッピングできます。
自由形式の抽出は別の目的に適しています。あらかじめ定義されたスキーマに対する値を返すのではなく、自然言語プロンプトを使って、まだ構造化メタデータとしてモデル化されていない情報を取得または要約します。自由形式のアプローチは探索に適しており、構造化抽出は予測可能な後続データが必要な反復可能なプロセスに適しています。
大規模運用に耐える信頼性を設計する
本番環境の抽出ワークフローを構築するには、単にAIモデルを呼び出すだけでは不十分です。一般的な運用上の考慮事項には、処理量と同時実行の管理、ファイルイベントと再試行の処理、アウトプットの検証、障害の監視、AIモデルやスキーマが進化しても予測可能な動作を維持することなどがあります。
これらの機能をネイティブに提供するプラットフォームは、構築・保守する必要のあるカスタムインフラを減らし、開発者がビジネスロジックと統合により集中できるようにします。
抽出データをどこに置くかを決める
同じ情報でも、システムによって必要な表現形式が異なる場合があります。コンテンツプラットフォームはソースドキュメントとそのネイティブメタデータの正となるシステムであり続ける一方、検索インデックスは高速な検索を提供し、データプラットフォームはレポートや分析を支援できます。
一般的なパターンには、次のものがあります。
- リクエスト時アクセス: アプリケーションが必要なときに、正となるソースから最新情報を直接取得します
- インデックス型検索: 選択したコンテンツまたは表現形式を検索インデックスやベクトルインデックスに保存し、ソースへのリンクを維持しながら高速に検索できるようにします
- 分析用レプリケーション: 選択した抽出メタデータをデータウェアハウス、レイクハウス、その他のデータプラットフォームへコピーし、レポートやモデリングに利用します
目標はコピーをなくすことではなく、抽出情報がどこで利用されても、権威性、権限、プロベナンス(出典)、ライフサイクルの一貫性を維持することです。
まず1つの繰り返し可能なビジネスプロセスから始める
実践的な最初の実装は、1つのドキュメントタイプと、明確に定義された1つのビジネス成果を選ぶことです。メタデータスキーマを定義し、関連するドキュメントが到着したら自動的に抽出を実行し、重要なフィールドを検証し、生成されたメタデータを1つの後続アプリケーションまたはワークフローで利用できるようにします。
たとえば契約更新ワークフローでは、顧客名、更新日、契約金額、契約識別子を抽出できます。メタデータは契約書との接続を維持したまま、一部のフィールドをCRMや分析システムでも利用できるようにします。これにより、今後の更新を特定し、アカウントワークフローを開始し、基になる情報をソース契約書まで追跡できます。
Boxが自動メタデータ抽出をどのように支援するのか
Box Extractは、構造化メタデータスキーマを定義し、AIを活用したBox AI抽出エージェントによってその情報を特定してBox内のコンテンツに直接適用できるようにします。メタデータ抽出は、コンテンツの到着時に自動化したり、オンデマンドで開始したり、APIを通じてプログラムから呼び出したりできます。
抽出されたメタデータはソースコンテンツとの接続を維持できるため、組織は基になるファイルのコンテキスト、権限、ガバナンスを保ちながら、検索、アプリケーション、分析、ワークフロー、AI全体でそのメタデータを利用できます。またBoxは、外部システムやAIアプリケーションをコンテンツそのものの正となるリポジトリにすることなく、企業コンテンツをそれらのシステムやアプリケーションへ接続できます。
よくある質問
エージェンティックデータ抽出とは何か、どのように機能するのか?
エージェンティックデータ抽出は、単一の抽出リクエストだけに依存するのではなく、複数ステップのプロセスの一部としてAIを使い、ドキュメントから情報を特定、解釈、構造化します。より高度なシステムでは、信頼性を高め、曖昧さを解消し、抽出値に追加のレビューが必要かどうかを判断するため、検索拡張生成(RAG)、思考連鎖による推論、AIグレーダー、検索、検証、評価の技術を組み合わせる場合があります。
AIは、非構造化ドキュメントから構造化データを抽出できるか?
はい。AIは、レイアウト、表現形式、フォーマットが異なるドキュメントでも、ビジネスに関連する情報を特定し、あらかじめ定義されたスキーマへマッピングできます。たとえば、同じ抽出スキーマを使って、見た目が大きく異なる請求書から、サプライヤ、請求金額、支払日を取得できます。
AIを活用したデータ抽出の精度をどのように確保するのか?
明確なスキーマとフィールド指示を定義し、代表的なドキュメントでテストし、フィールド単位で結果を評価し、信頼度シグナルやビジネスルールを使って確認が必要な可能性のある値を特定することで、抽出精度を高めます。高リスク、曖昧、不確実なフィールドには、人による検証を追加できます。
メタデータ抽出にはどのようなコンプライアンス要件が適用されるのか?
コンプライアンス要件は、コンテンツの種類、業界、法域、抽出データの処理・保存方法によって異なります。プライバシー、データ保持、アクセス制御、監査可能性、データレジデンシ、業界固有の規制に関連する要件を考慮する必要があります。抽出メタデータは、ソースコンテンツとともに保持される場合でも、別のシステムに複製される場合でも、適切に管理される必要があります。
データ抽出プロセスをどのように監査するのか?
どのコンテンツが処理されたか、どの値が抽出されたか、抽出がいつ行われたか、値がどのソースとバージョンから得られたか、その後結果がどのようにレビューまたは変更されたかを記録することで、メタデータ抽出を監査できます。ユースケースによっては、監査記録にユーザーやアプリケーションのアクセス、AIモデルまたはサービス情報、後続のアクションを含める場合もあります。
抽出中の機密データをどのように保護するのか?
コンテンツがどこで処理されるかを制御し、適切な権限を適用し、転送中・保存中のデータを暗号化し、保持を制限し、ソースコンテンツと抽出メタデータの両方にガバナンスポリシーを適用することで、機密データを保護します。既存の管理されたコンテンツ環境内で抽出することで、管理しなければならない追加のコピーやアクセスモデルを減らせます。
AIドキュメント抽出APIでは何を確認すべきか?
優れたドキュメント抽出APIは、構造化スキーマ、予測可能なアウトプット、バッチ処理と非同期処理、プロベナンス(出典)またはソース参照、エラー処理、後続システムやワークフローとの統合をサポートすべきです。購入側は、セキュリティ、ガバナンス、スケーラビリティ、対応するドキュメントフォーマット、スキーマや基盤AIモデルの変更をAPIがどのように扱うかも評価する必要があります。
保険会社は、保険金請求ドキュメントからどのようにメタデータを抽出するのか?
保険会社は、保険証券番号、請求者、損害発生日、車台番号(VIN)、負傷の詳細、保険金請求額などの情報を含む保険金請求スキーマを定義し、フォーム、写真、連絡文書、査定担当者のメモからそれらのフィールドを抽出できます。生成されたメタデータは、保険金請求システムへの入力、トリアージの支援、不足情報の特定、査定担当者のレビューが必要かどうかの判断に利用できます。
人事部門は、従業員ドキュメントからどのようにメタデータを抽出するのか?
人事部門は、履歴書、オファーパッケージ、オンボーディングドキュメント、人事ファイルから、連絡先情報、面接日、オファー条件、報酬、入社日、役職、従業員識別子などの候補者・従業員情報を抽出できます。その構造化データは、応募者追跡システムやHCMシステムへの入力、オンボーディングや記録管理ワークフローの支援に利用できます。
金融機関は、ローンドキュメントからどのようにメタデータを抽出するのか?
金融機関はAI抽出を使って、ローンドキュメントから、借り手・取引相手の名称、融資額、金利、満期日、コベナンツ条件、支払義務などの情報を取得します。生成されたメタデータは、融資審査、サービシング、コンプライアンスレビュー、分析、後続システムの更新を支援できます。
請求書からどのように自動でデータを抽出するのか?
サプライヤ、請求書番号、発注番号、金額、税額、支払期日などのフィールドを含む請求書スキーマを定義し、請求書の到着時にそれらの値を自動抽出できます。検証済みのメタデータは財務システムやERPシステムへ送信し、例外はレビューに回すことができます。
政府機関はメタデータ抽出をどのように利用するのか?
政府機関は、許認可、助成金、給付案件、公開記録処理、調達、その他のドキュメント中心のワークフローでメタデータ抽出を利用できます。申請者情報、案件識別子、日付、住所、手数料、適格性情報、法定期限などの抽出フィールドによって、記録をより検索、ルーティング、追跡、処理しやすくできます。
メタデータ抽出の恩恵が最も大きい業界は?
メタデータ抽出は、金融機関、保険会社、法務、ヘルスケア・ライフサイエンス、政府、製造業など、大量のドキュメントベース業務、複雑なビジネスルール、重要なコンプライアンス要件がある業界で特に価値があります。最大の価値は通常、情報を手作業で探す、再入力する、検証するといった作業がコスト、遅延、運用リスクを生み出している場所で現れます。
自社のコンテンツでどのように機能するか確認してみませんか? Boxは、バージョン、メタデータ、権限、データ分類、ライフサイクルポリシーとともに企業コンテンツを管理し、従業員、アプリケーション、AIエージェントがファイルを扱う際にも、それらの制御をファイルに関連付けたまま維持します。
詳細は、Box Japanの営業担当にご相談いただくか、こちらからお問い合わせください。
関連コンテンツ
- 新しいBox Agentのご紹介: コンテンツをAIが必要とするコンテキストに変える
- インテリジェントなコンテンツ管理のためにBox AIを強力に機能拡張
- AIの回答精度を左右する「データの渡し方」
- 正答率 94% vs. 10%: 同じAIでも、渡すデータでここまで変わる
- AI活用のために始めるべきメタデータ整備
- Box Extractのご紹介: 膨大な企業コンテンツから実用的なメタデータを抽出
- Box AIとは?
このブログは Box, Inc 公式ブログ(https://blog.box.com/)2025年9月9日付投稿の翻訳です。
原文リンク: https://blog.box.com/metadata-extraction-enterprise-guide-cdos-it-leaders
